
具身智能体长程记忆:看见不等于记住,浙大提出具身记忆基准
新智元报道
新智元报道

设想一个日常场景:
家庭机器人刚刚在茶几上看见一本书,去厨房完成几项任务后,接到取书的指令,却又开始挨个房间搜索。它已经试过一个打不开的抽屉,过了一会儿,还是回到同一个抽屉前反复尝试。
对人来说,「记得东西放在哪里」「知道它后来被挪走了」「记住哪些办法行不通」,都是日常生活中的基本能力。
但对具身智能体来说,把过去的观察、行动和反馈连起来,并在下一次任务中用上,仍然是一道难题。已有基准开始关注视觉历史、空间状态更新等问题,但对长期交互中的多种记忆需求,仍缺少统一的行动评测。
当 AI 走进持续变化的物理世界,它究竟需要怎样的记忆?又该如何判断,它是否真的记住了,并能据此行动?
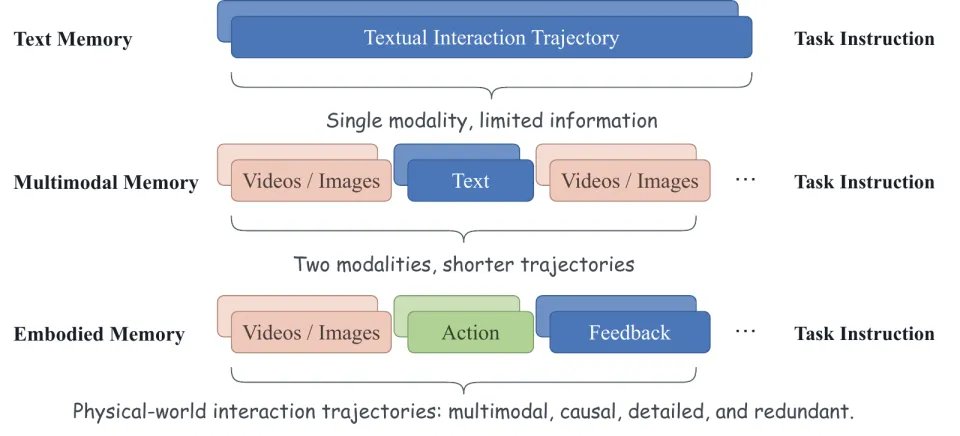
具身记忆需要连接视觉观察、行动与环境反馈,保留交互过程中的状态变化和因果关系。
为了回答这个问题,浙江大学OmniAI团队提出EmbodiedMemory-Bench(EMem-Bench):通过四类任务、2,554条可执行的交互样本,系统评测智能体能否从历史中建立记忆,并用它完成后续任务。
该工作还提出外部记忆系统Embodied-Memorizer(EMem),以及学习管理和使用记忆的EMem-8B模型。发布三周左右,该benchmark在Huggingface上下载量已经接近30,000次。
论文链接:https://arxiv.org/abs/2609.28236
项目主页:https://zju-omniai.github.io/Embodied-Omni/EmbodiedMemoryBench/
代码链接:https://github.com/ZJU-OmniAI/Embodied-Omni/tree/main/embodied_memory
基准链接:https://huggingface.co/datasets/lzLiang/EmbodiedMemoryBench
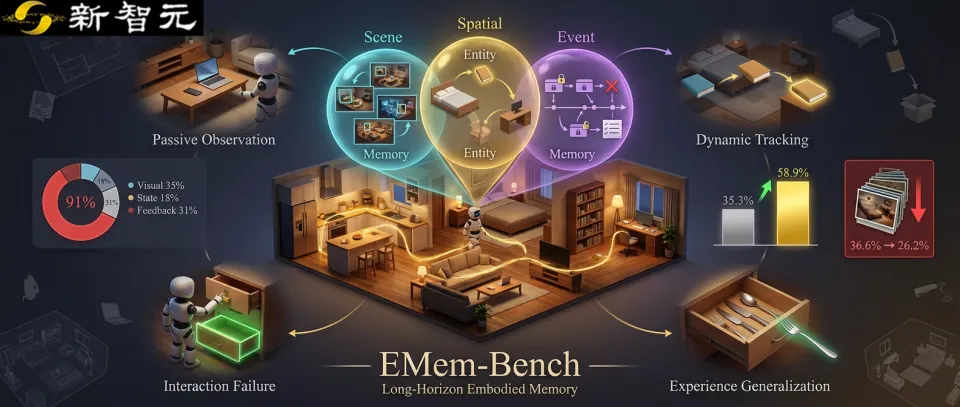
为了找出长程具身任务中的困难,研究团队首先分析了Gemini-3-Flash和Qwen3-VL-32B在EmbodiedBench的EB-ALF、EB-Hab上的100条失败轨迹。其中,四类与具身记忆相关的问题合计占到91%:
忽略细粒度视觉线索(35%):目标曾经出现在画面里,模型却没记住它的位置,后续只能反复搜索。
遗漏环境状态变化(18%):物体已经被移动或处理,模型仍然依据旧状态行动。
未记录交互反馈揭示的状态(31%):抓取是否成功、环境的隐藏状态,这些信息需要从行动结果中确认并记住。
未能迁移过去的经验(7%):之前的示范或纠正已经给出线索,换一个对象后,模型却仍然犯同样的错误。
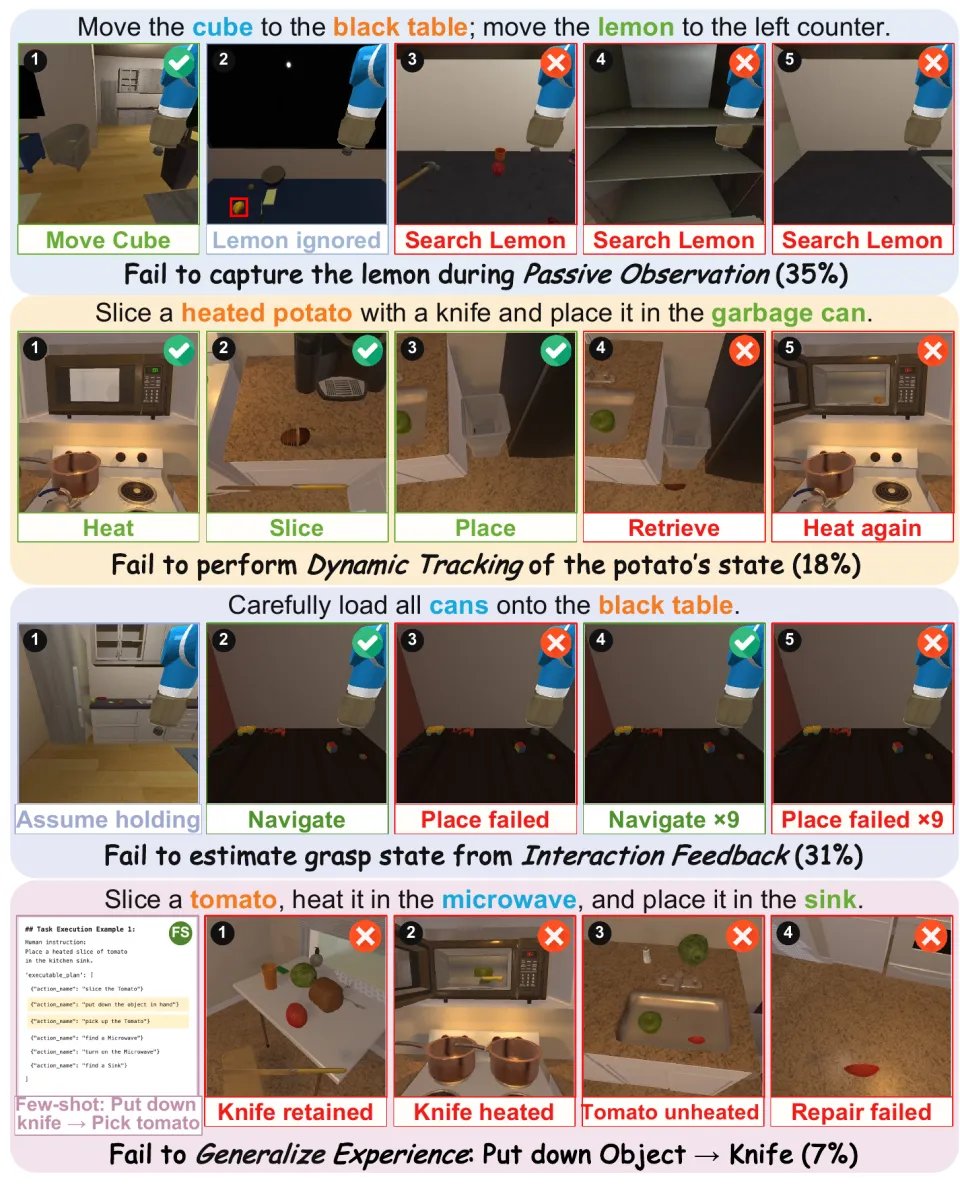
图中比例来自对上述100条失败轨迹的分析,展示了视觉遗漏、状态跟踪、反馈记录和经验迁移方面的问题。
这些现象指向了具身记忆的特殊要求:有些信息只在某一帧中短暂出现;有些记忆需要随着环境变化被更新;有些状态必须通过交互才能发现;还有些经验需要从具体事件中归纳,再迁移到新的对象。
例如,「抽屉打不开」并不一定能从一张图像中判断出来,它需要一次尝试和相应反馈;「餐具应该放在这个抽屉」也不是物体位置的简单记录,而是多次纠正共同表达的规律。具身记忆需要保留这些信息的来源与联系,让后续行动有据可依。
EMem-Bench的每条样本都提供一段按时间排列的多模态交互历史,再给出一个后续任务。
智能体需要从历史中找回关键证据,并在仿真环境中执行导航、打开容器、拿取和放置等动作,直到达到任务要求的终态。评测由此把「过去发生过什么」与「现在应该怎样行动」连接起来。
基准围绕四种记忆需求设置了四类任务:
1. 被动观察(Passive Observation):考察智能体能否保留执行其他任务时偶然看到的细粒度视觉信息,并在后续任务中找回相关物体的位置。目标可能混在多个物体中,观察时也尚不知道它之后会被需要。例如,笔记本电脑曾经出现在茶几上,过了一段时间,新的任务要求拿起电脑,智能体需要利用那次观察找到它。
2. 动态跟踪(Dynamic Tracking):考察智能体能否随物体位置或状态的变化,持续更新对环境的认识。历史中可能包含同一物体在不同时间的多条记录,模型需要判断当前有效的状态,避免依据过时信息行动。例如,一本书先在床上,后来被放进盒子,最后移到书桌上,智能体应依据最新的位置寻找它。
3. 交互失败(Interaction Failure):考察智能体能否记住行动结果揭示的环境状态与交互限制,并据此调整后续选择。锁住的抽屉、不可用的容器等信息需要通过尝试获得,反馈还必须与具体对象对应。例如,一次开抽屉失败揭示了「上层抽屉锁住了」,后续存放钥匙串时,智能体需要利用这条反馈,选择可以使用的下层抽屉。
4. 经验泛化(Experience Generalization):考察智能体能否从多个对象的纠正经历中归纳共同规律,并将其应用于历史中没有出现过的新对象。这要求模型理解过去的经验为何相关,以及适合迁移到哪些情境。例如,过去几次纠正都要求把刀、勺子收进抽屉,面对新出现的叉子,智能体需要迁移这户家庭的收纳习惯。

四类任务分别考察视觉细节保留、最新状态更新、交互反馈记忆,以及从过去的纠正中学习可复用经验。
研究团队先选择可导航、可交互的多房间环境,再围绕四类任务构造决定后续行动的记忆线索。AI2-THOR的单房间场景被组合成虚拟家庭,智能体离开并返回房间时,房间状态会被保留;ProcTHOR则直接提供多房间住宅。
随后,规划器在关键线索前后插入与目标无关的交互,拉开线索与后续任务的距离。这些干扰轨迹必须能够实际执行,同时不能触碰关键物体、泄露答案,或改变目标任务所依赖的状态。这样,历史变长了,完成任务所需的证据仍然能够被明确定位。
前三类任务的历史长度中位数为78–83步,经验泛化任务达到111步;各任务族的关键线索与目标任务之间,中位间隔仍有52–56步。被动观察任务的关键画面平均包含11个可见物体,也对细节记忆提出了要求。
基准覆盖1,118个场景、125种可见物体、83种目标物体和33种容器及承载物。自动检查验证环境、轨迹、证据与可行解,人工审核则进一步检查指令是否清楚、历史是否合理、线索是否足以支持预期行动,以及任务终态是否判断正确,最终保留2,554条。
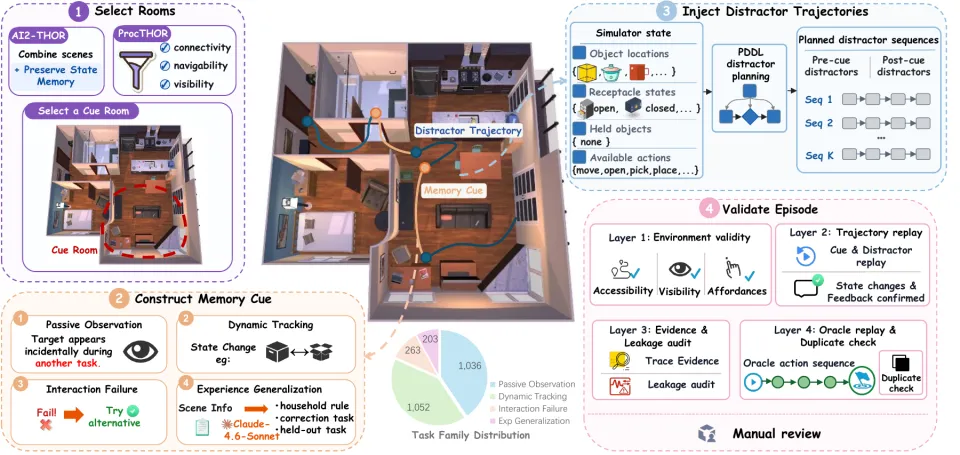
从多房间环境、任务相关记忆线索与干扰轨迹出发,经过自动验证和人工审核,形成可执行的评测样本。
为了探索怎样改善这些问题,作者提出EMem,将具身经验组织成三种互补的记忆:
场景记忆(Scene Memory):保存选定的视觉画面、描述和其中识别到的物体,并与所在场景绑定,帮助区分「厨房的杯子」和「卧室的杯子」。相似画面会经过筛选,尽量保留新增物体和有用的视觉细节。
空间记忆(Spatial Memory):通过实体图维护物体的位置、关系和属性。书从床上移到书桌后,新的位置关系会替换冲突的旧关系,同时保留其他仍然有效的属性,形成最新已知的世界状态。
事件记忆(Event Memory):按时间记录行动、结果和纠正,保留「这个抽屉打不开」等交互证据。多次相关纠正还可以被归纳成简短规则,并关联支持它的原始事件,供面对新对象时检索。
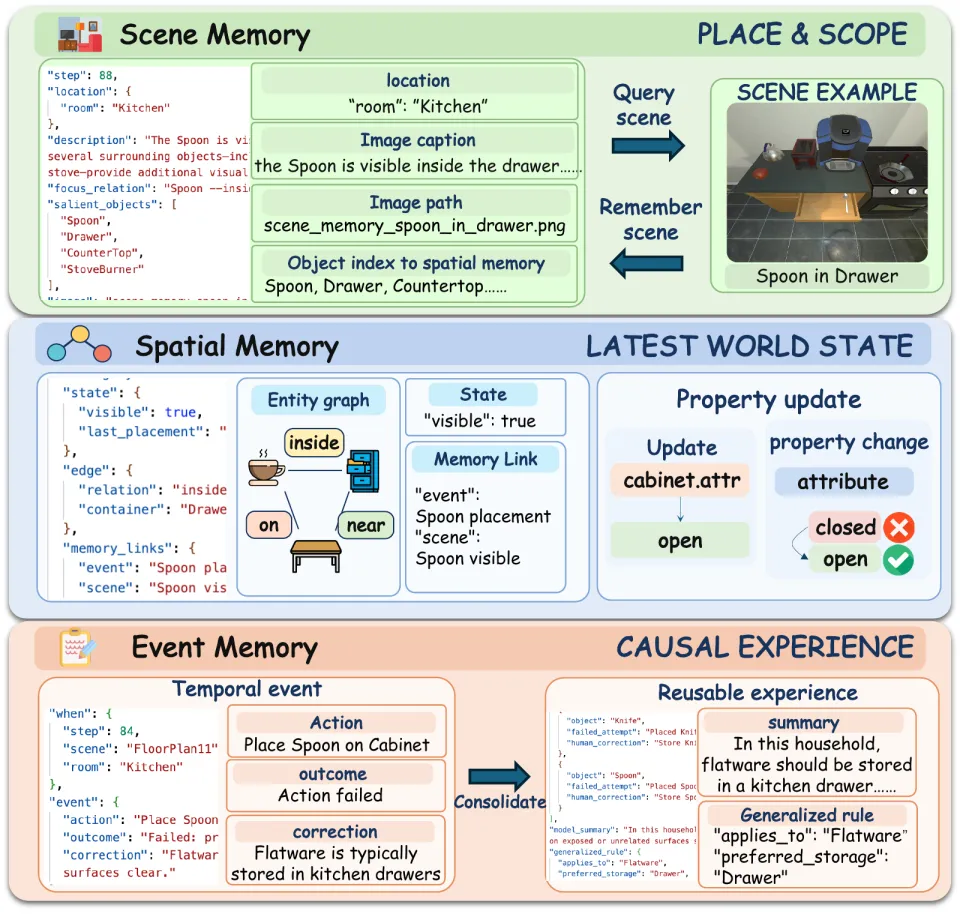
场景记忆保留视觉与场景信息,空间记忆维护最新世界状态,事件记忆保存交互结果并归纳经验。
整个过程形成「观察—写入—检索—行动—反馈更新」的循环。模型按时间顺序处理历史,每一步依据当前画面、上一动作及其反馈决定写入什么。此时,后续任务尚未给出,记忆需要从已经发生的交互中积累。
接到任务后,模型选择需要查询的记忆。找一本书需要最新的位置,避开锁住的抽屉需要过去的失败反馈,收纳新餐具则可能需要多次纠正归纳出的规则。检索先依据场景、实体和关系等结构条件筛选,再补充文本匹配与必要的语义匹配,将相关证据交给行动阶段。
执行产生的新观察和反馈继续更新记忆。如果动作失败或重要状态发生变化,系统会中断尚未执行的计划,重新查询和规划。这样,之前的行动结果能够影响下一次决策,记忆也随交互持续更新。
有了外部记忆,模型仍需要决定哪些信息值得保存、当前任务应该查询什么,以及如何把检索结果转化为行动。作者进一步对Qwen3-VL-8B进行监督微调,得到EMem-8B,围绕这三个决策提供训练,让模型学会如何进行记忆操作。
实验比较了通用开源模型、具身模型、闭源多模态模型,以及代表性的多模态记忆系统。结果显示,各类模型在四种能力上的表现仍然不均衡。
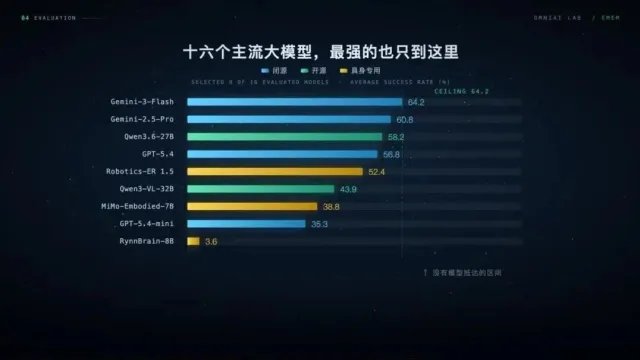
在论文的full-context设置下,模型获得完整的文本历史,并在执行时接收当前视觉观察。Gemini-3-Flash以64.2%的平均成功率位居该设置首位;Gemini-2.5-Pro为60.8%,开源模型Qwen3.6-27B为58.2%,GPT-5.4为56.8%。
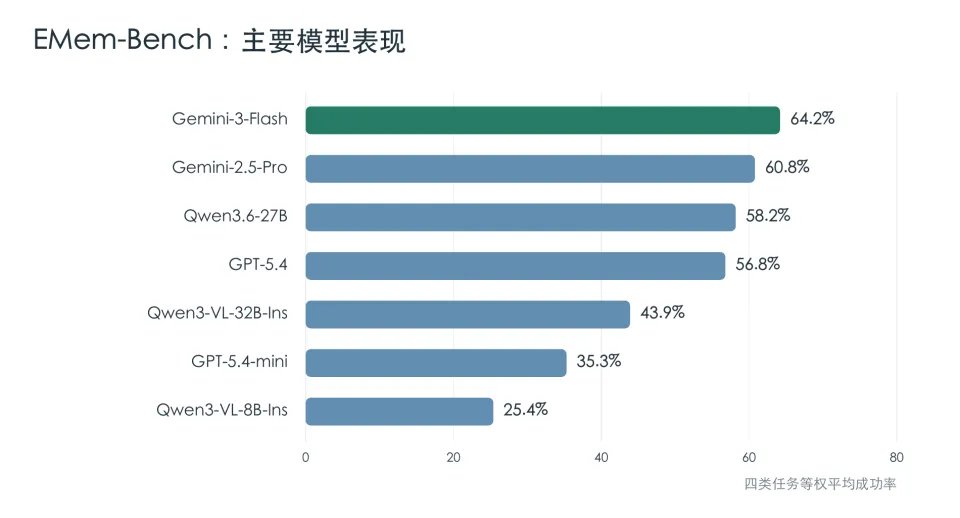
根据论文Table2绘制的部分模型结果。平均成功率为四类任务的等权均值,full-context使用文本历史和当前视觉观察。
即使是同一个模型,不同记忆能力之间也可能存在很大差距:Qwen3-VL-32B在经验泛化上的成功率达到63.1%,但动态跟踪只有20.3%。具身模型的专门训练也没有稳定转化为长期记忆优势,表明空间感知与规划训练还需要进一步覆盖状态维护和经验使用。
固定GPT-5.4-mini为骨干,EMem将平均成功率从35.3%提升到58.9%,增加23.6个百分点。在这一比较中,其他记忆系统的最佳结果为TeleMem的37.8%,EMem的整体优势达到21.1个百分点。
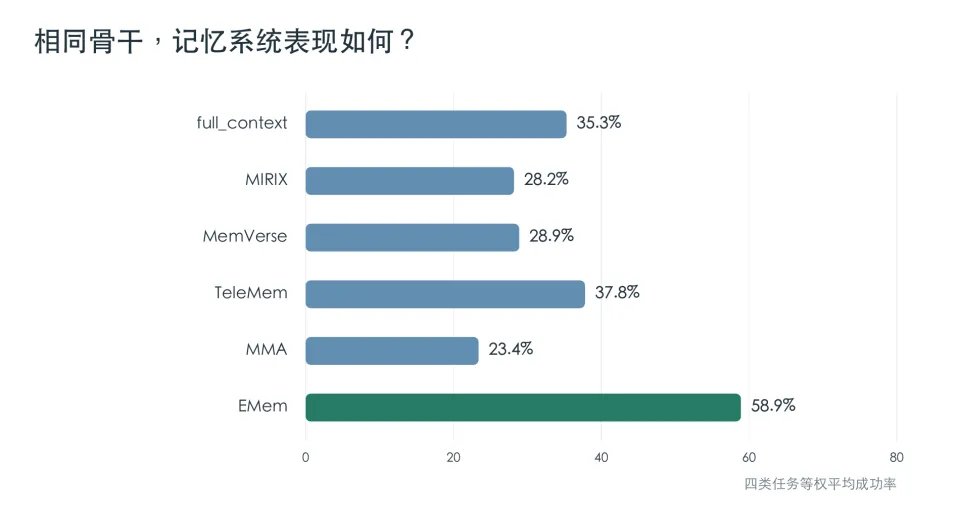
所有系统使用相同的GPT-5.4-mini骨干。EMem在论文评测的记忆系统中取得最高的平均成功率。
提升同样出现在开源骨干上:无需任务专门训练,EMem在Qwen3-VL-8B、Qwen3-VL-32B和Mistral-Small-3.1-24B上分别带来10.8、14.1和16.4个百分点的平均成功率提升。经过记忆操作训练,EMem-8B达到46.0%,比原始Qwen3-VL-8B提高20.6个百分点,比冻结骨干直接使用EMem再提高9.8个百分点。
消融实验也支持三种记忆的互补性:完整系统的平均成功率为58.9%,移除任一记忆后都降至46.9%–47.9%。其中,动态跟踪更依赖空间记忆,交互失败与经验泛化更依赖事件记忆,被动观察更依赖场景记忆。
一个自然的想法是:既然模型会忘记,能否直接把更多历史图像塞进上下文?
作者用GPT-5.4-mini在固定的800条样本上进行了对照实验,每类任务各200条。两种设置都保留完整文本历史和当前图像,扩展设置再加入上下文预算允许的尽可能多的历史图像。结果如下:

论文Table3原始结果。两种设置使用相同的800条样本和行动预算;输入tokens为每条样本均值。
在这组对照实验中,平均成功率从36.6%降至26.2%,下降10.4个百分点;每条样本平均输入tokens从41,770增至206,489,约为原来的4.9倍;每步模型延迟从4.1秒增至39.1秒,约为原来的9.5倍。这说明原始历史的堆积不能替代有效记忆;关键在于找回任务相关证据、更新过时状态,并抑制无关信息。
在进一步的失败分析中,作者检查了EMem-Bench上GPT-5.4-mini的400条失败样本,每类任务各100条。其中61.3%属于记忆使用错误:模型采取的行动与已有历史证据相冲突。分析发现,交互失败任务还包含较多上下文推理错误——记住一次失败之后,模型仍需要理解这条反馈,并形成新的可行决策。
EMem-Bench通过四类可执行任务评测长期具身记忆,并以EMem和EMem-8B探索记忆的组织、更新与使用。让过去的观察、行动和反馈成为后续决策的依据,是这项工作关注的核心能力。
当前结果主要来自仿真环境。未来还需在更长时间跨度、更复杂环境和真实机器人上,检验这些能力面对传感器噪声、执行误差与开放世界变化时的表现。
浙江大学OmniAI团队致力于大模型与智能体、多模态空间推理、具身智能和情感交互等方向研究。作者梁立州为浙大一年级硕士。通讯作者为浙大研究员张文祺。
参考资料:
https://arxiv.org/abs/2609.28236
编辑:LRST
