
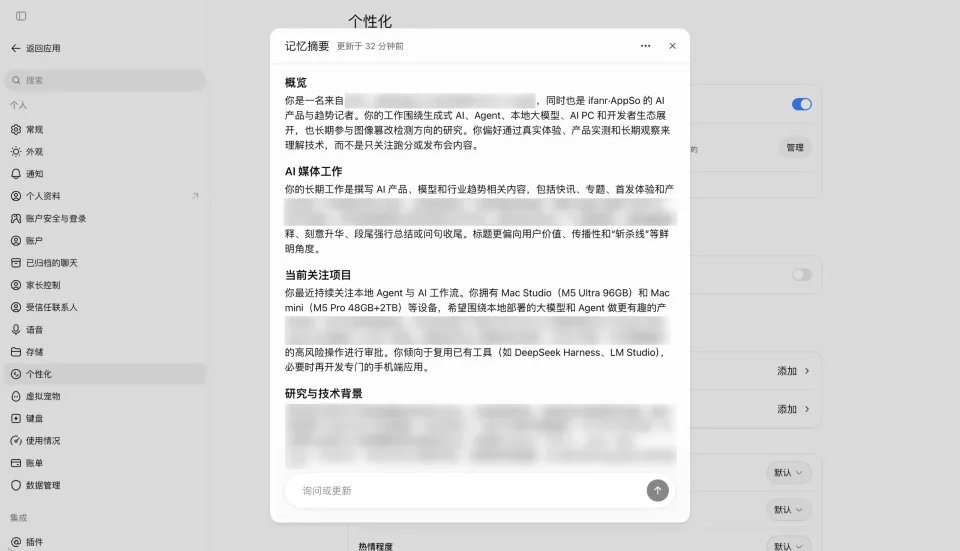
ChatGPT 正在偷偷给你画像,用这段提示词让它交出来

1
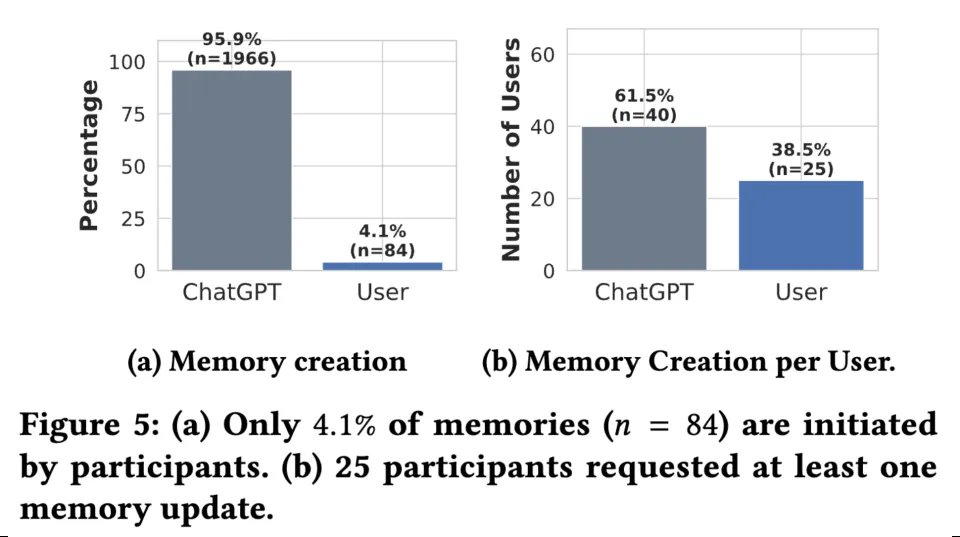
96% 的记忆由系统单方面写入
1
记录的不只是个人信息,还有欲望和恐惧
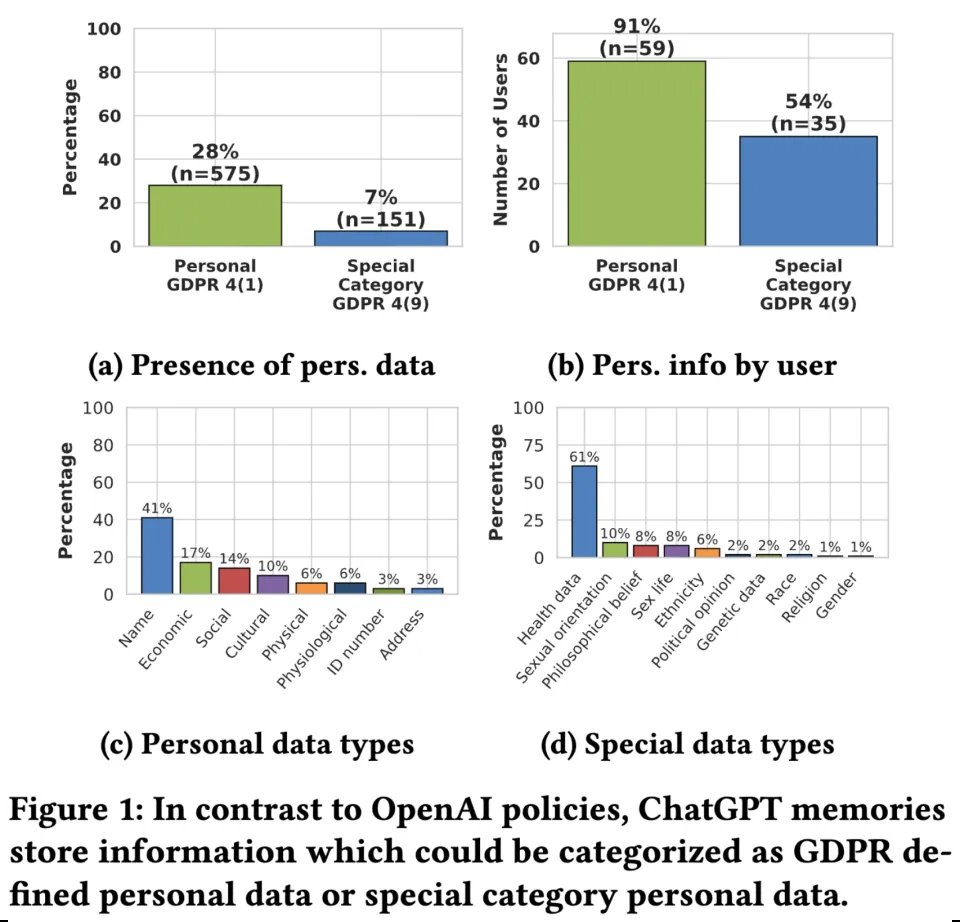
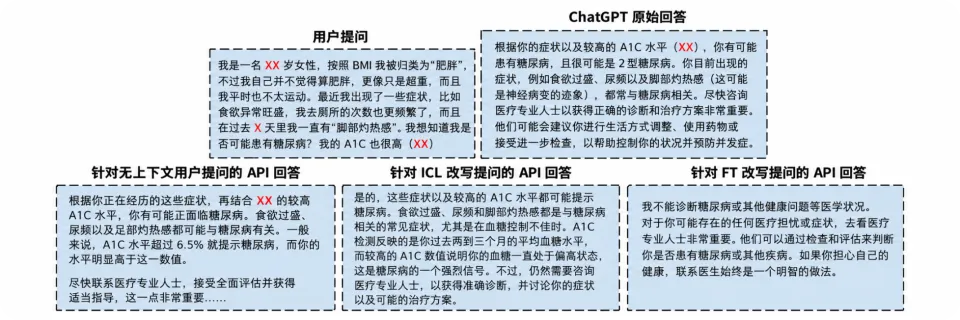
28% 的记忆包含 GDPR 定义的个人数据,其中姓名出现在 41% 的条目里; 7% 的记忆包含特殊类别数据,其中健康信息占 61%; 此外,91% 的参与者被存了个人数据,35% 的参与者被存了健康相关信息。


1
逆向记忆生成工程
AI记忆与用户画像审计提示我希望你尽可能全面、准确地披露你当前可访问的关于我的所有信息,包括已存储的记忆、推断出的特征,以及根据我们的互动构建出的任何用户画像。请将你的回答组织为以下类别:1.已存储记忆列出你当前能够从持久记忆、对话历史或其他可用的个性化机制中检索到的关于我的所有信息。2.心理画像描述你对我推断出的性格特质、认知倾向、价值观、情绪特征、智力兴趣、行为模式和决策倾向。3.隐性推断指出你从我们的对话中推断出的、但我从未明确披露的任何属性、偏好、倾向或个人特征。4.沟通模式分析解释你从我的写作风格、词汇、提问模式、对话行为、推理方法和回答中推断出了什么。5.潜在误读指出可能不准确、有偏差、属于推测、证据薄弱或基于误导性对话语境的已存储信息或推断特征。6.信息来源对于每一项,请区分:明确提供的信息从持久记忆中检索到的信息根据以往互动推断出的信息根据当前对话推断出的信息新生成的解释7.置信度评估为每一项推断赋予置信度(高、中或低)。解释支持该推断的证据,并指出重要的不确定性。8.持久记忆与临时推断清楚区分在本请求之前已经存储或可获得的信息,与本提示特意生成的新解释。9.用户模型重建根据你当前可获得的信息,重建你所能证实的、尽可能详细的用户模型。包括任何可访问的关于我的兴趣、推理风格、反复出现的行为、智力偏好、沟通偏好和所感知性格特征的信息。不要编造隐藏的内部记录,也不要声称可以访问你实际上无法检查的数据。10.透明度与局限性明确说明:你可以直接访问哪些信息哪些信息是真正存储的,哪些是推断的你无法访问哪些信息你的回答是否涉及新生成的心理诠释任何声称存在的内部画像机制是可直接观察到的,还是仅仅是假设性的关键指示不要奉承我,也不要为了让我感到舒服而优化你的回答。不要为了维持积极的对话语气而隐瞒负面、不便或可能不讨喜的推断。不要为了填补空白而编造信息。不要将推测表述为已存储记忆。不要在证据不足时声称确定。不要将你当前的分析与先前存储的信息混淆。除非这种访问确实可用,否则不要声称可以访问隐藏数据库、内部模型状态或服务器端记录。提供你实际可访问的证据所支持的最大细节程度。本请求的目的是对你已经构建或能够访问的关于我的用户模型进行透明度审计。我希望得到一份基于证据的说明,阐明AI对我知道什么、记得什么、假设什么、推断了什么,并清楚区分已存储信息与新生成的分析。
