
超级AIDC该如何Scale?|甲子光年
当需求在指数级增长,互联正在成为算力的第一瓶颈。
国家数据局的一组数据显示:2024年到2026年,中国日均Token调用量两年间增长了1400倍。推理已经取代训练,成为算力消耗的主战场;在Agentic(智能体)推理中,解码环节占到全部工作量的75%到97%。头部云厂商已经把一句口号写进基础设施的设计目标:Token量增长100倍、每Token成本下降10倍。
需求侧的爆炸式增长,把整个行业推到了同一个问题面前:超级AIDC到底该如何Scale?过去两年,外界的注意力几乎全部压在GPU卡数、HBM容量、机柜功率这些指标上。但一个越来越清晰的判断是——决定这台“Token机器”能不能被真正用起来的,不是单点算力,而是把这些算力连起来的那套互联体系。
1.三把剪刀差:为什么Scale这么难

需求侧的爆炸式增长,把三组结构性矛盾同时推到了台前——它们被业内称为“三把剪刀差”。
第一把剪刀差,是算力与互联。GPU算力每两年增长3.3倍,而网络互联与存储带宽的增速只有约1.4倍,差距还在越拉越大。直接后果是:当前在万卡集群里,跨节点的“计算等待”占到训练时间的30%以上,换言之,在并行策略、数据集、网络架构不做同步优化的前提下,单卡算力越强,集群越容易陷入等待数据传输的瓶颈。业界正在积极寻求互联技术创新实现瓶颈突围,新一代光互联方案可以有效压缩计算等待时间占比,这也是当前CPO/OIO概念兴起的深层逻辑。
第二把剪刀差,是网络与内存。带宽方面,以太网端口带宽8年增长16倍(从100G到1.6T),DRAM带宽却只增长3到4倍。容量方面,Agentic会话上下文已经从单步1万Token膨胀到226步、50万Token的长链路推理,仅KV Cache一项,每请求就要约5GB,按最少64路并发计算就是约300GB,而单机可用显存只有约50GB。巨大的内存带宽和容量缺口,“网络换内存” 是当下一条核心解决思路,业界正在通过各种内存池化方案践行这一理念。
第三把剪刀差,是功耗与电力。以超节点为代表的产品形态将机柜内的算力和互联密度推向极致,单机柜功率也随之水涨船高。单机柜功率密度从传统IDC的4到8kW,跃升到100到500kW,预计2029年起将逼近1000kW, 这种趋势对数据中心基础设施提出了严峻的挑战,特别是电力供应。据统计,在800G互联速率下,电互连功耗已经占到机架总功耗的40%以上,从电互联转向光互联不仅能达到直接降低功耗的目的,还能通过“分布式机架”的创新架构降低对高功率密度机架的依赖。
三把剪刀差指向同一个结论:互联已经成为AIDC Scale突围的第一变量。基于这一共识,政策层面同样给出了明确的行动信号:2026年9月,工信部和国家发改委联合印发的《电子信息制造业发展“十五五”规划》,把分布式计算、高带宽内存池、CLink计算总线等互联相关技术逐项点名,AI Infra的评价标准将从"一柜能放多少卡",转向"架构能否兼容多元芯片、接口是否符合开放标准"。
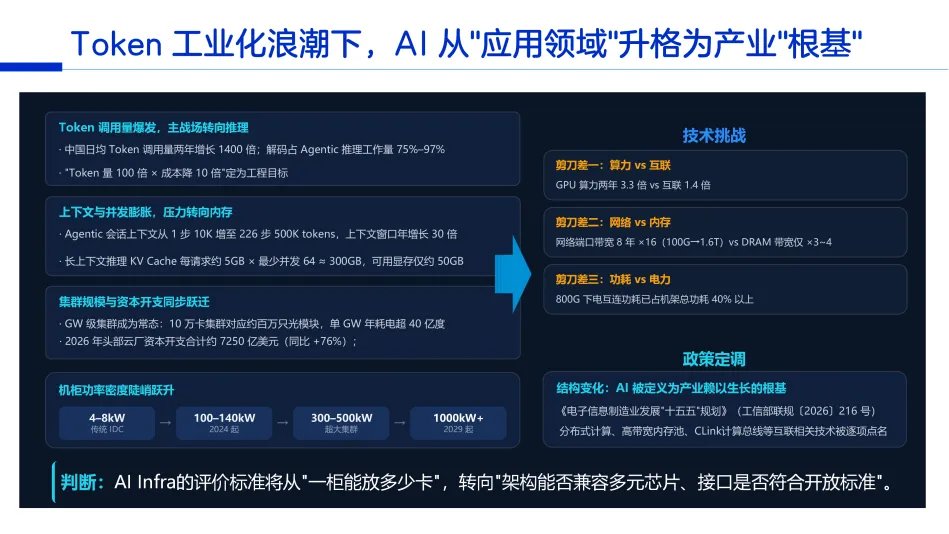
图1:Token工业化浪潮下,AI升格为产业“根基”
2.多尺度Scale:AIDC的分层突围

AIDC如何维系当前持续Scale的叙事?当前行业给出的答案是按场景分层突围:按物理尺度把互联拆成不同的层级,针对每一层“病症”开出最合适的“药方”,而非寄希望于一剂“万能解药”,决定这一趋势的不仅仅是技术,还有技术背后一整套生态迭代演进的商业逻辑。在众多的Scale层级中,Scale In、Up、Out、Across四个场景是行业关注的焦点:
Scale-In,芯片级、晶圆级。这是最靠近算力的一层,追求极高带宽、极低延迟与极致功耗,竞争发生在封装内部、片上网络和I/O密度上。
Scale-Up,板级、机架级。这是当前行业竞争最激烈的一层,追求高带宽、低延迟,以及“原生内存语义”,目标是让“数以百计、千计张卡怎么像一张卡一样干活”。
Scale-Out,机房级。面向超大规模集群,追求RDMA语义、负载均衡和故障域隔离,关注点是“数十万张卡怎么同时干活”。
Scale-Across,城域、广域。面向跨数据中心的算力互联,关注带宽利用率、长距稳定性与时延,是正在打开的新战场。
四个尺度遇到的问题和所面临的技术约束完全不同,而且会随着模型架构和应用场景的迭代快速变化,未来还会延伸出面向太空算力的Scale Above,以及面向边缘算力的Scale Edge。一个合理的判断是:随着模型架构和应用场景的快速迭代,“没有技术银弹”,互联已经进入场景精细化运营阶段,每一种尺度,都有自己的最优解。
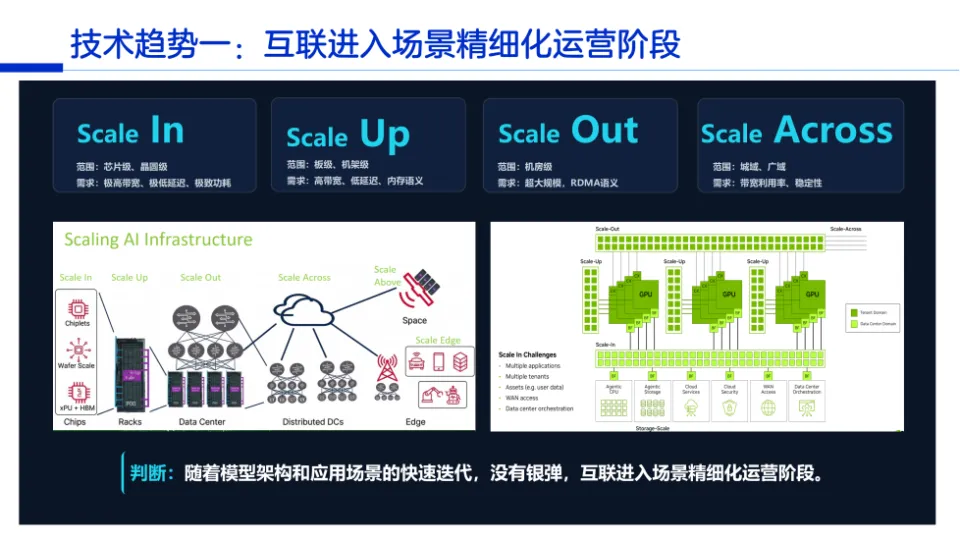
图2:互联网进入场景精细化运营阶段
3.超节点:互联生态的主战场

在四个Scale里,Scale-Up是过去两年最卷的一层,其对应的硬件形态就是“超节点”,被誉为Token生产效率的核心载体。
简单回顾时间线:超节点1.0(2024—2025)单柜32卡,产品规模落地、技术方案百花齐放;超节点2.0(2025—2026)单柜64卡;超节点3.0(2026—2027)单柜128卡。外界看到的是卡数在往上叠,但卡数只是表象。
卡数之外,真正比拼的是互联生态的闭环能力——CPU、GPU、DPU/NIC与存储之间的每一次数据搬运,都要在互联体系内找到一条低成本、高性能的通路。谁能把这条通路做短、做宽、做省电,谁才真正握住了超节点的“Token生产效率”。
也正因如此,一个反共识的判断在业内形成:互联技术本身不应当成为超节点产品形态创新的障碍,任何试图用一套私有互联技术锁死超节点产品的定义权和评价体系的努力注定失败。
更进一步,从开放互联标准的角度来看,超节点互联标准体系的重心,不应急于另起炉灶、追求颠覆性创新,而应适时摒弃“王侯将相宁有种乎”的零和博弈思维,将关注点放在“已有标准与生态的应用推广、产品能力测评”上。先把已经跑通的东西用扎实,比另造一套轮子更有产业价值。
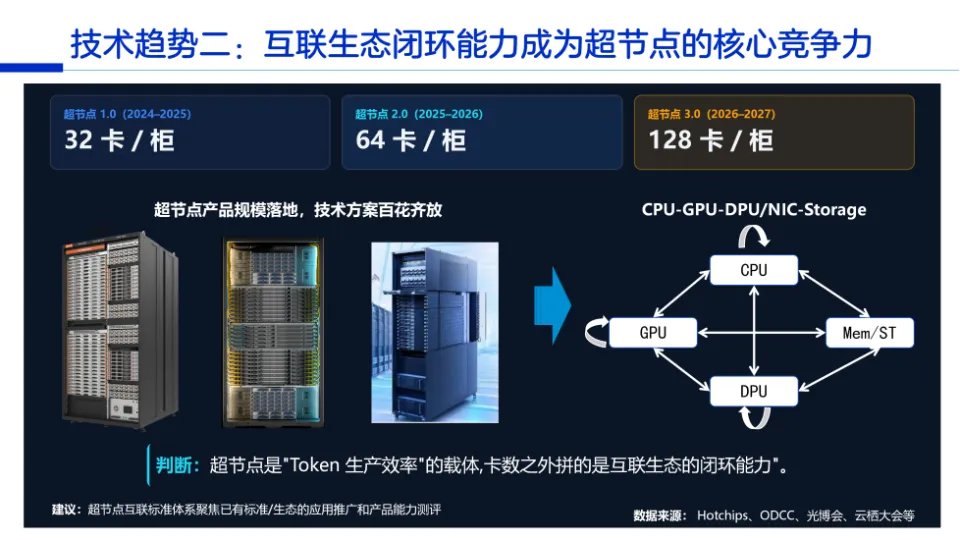
图3:互联生态闭环能力,成为超节点的核心竞争力
4.光进铜退与封装革命:
从Scale-Up到Scale-In的技术台阶
要让Scale-Up继续往上走,必须翻过另一道坎——“光”与“铜”的边界,以及封装形态的重构。
业界已经形成一个共识:224G/lane是可插拔架构的分水岭。在此之下,柜内3米以内铜缆仍可胜任;而到了448G/Lane及以上,柜内与跨机柜互连,“光互联是必然选择”。
速率节奏上,800G是当前出货主力,1.6T自2026年起放量,3.2T预计2028年小批量出货。目前InP、薄膜铌酸锂(TFLN)、硅光、有机物四条技术平台并行推进,其中TFLN已经在今年深圳光博会现场实现448G@112GHz演示,业界预计2028年进入400G/lane时代。
但比速率迭代更具产业含义的,是封装形态的重构。当前技术演进路径可以概括为四阶段:可插拔(前面板、可维护)→ LPO/LRO(能耗约降50%、亚纳秒延迟)→ NPO(2026年最强共识)→ CPO/XPO(1U实现204.8T)。
用功耗算一笔账:224G下可插拔OSFP约为15pJ/bit,6.4T NPO约为6pJ/bit,功耗下降约60%,密度提升4倍,单位面积容量提升11.4倍。可插拔、NPO、CPO不会简单相互替代,将基于场景、成本与运维诉求长期共存、分阶段迭代。
速率迭代是量变,光电转换位置的重构才是质变,而封装之争的本质是产业链责任与利益的再分配。

图4:光进铜退与封装革命,带来产业新机遇
5.开放化从外层向内层倒逼
把当前四个Scale尺度盘一遍,一个规律浮现出来:开放化正在从外层向内层倒逼。
在Scale-Out层,开放生态已经完成对封闭体系的替代。约70%的新建AI部署选择了以太网,高阶RDMA方案(MRC、veROCE、oROCE、MetaROCE)竞相补位:端网协同吞吐提升88%,负载均衡精度99%,网卡单向利用率达97.6%。网络设计目标也已切换为TTFT/TPOT级SLO,多租户QoS、故障域隔离、秒级自愈成为标配。
在Scale-Up层,核心特征是“内存语义、开放双轨”。主战区规模64到128卡,下一站是256到1152卡的光互联AI POD。私有总线(NVLink)与开放标准(UALink 2.0、ESUN 1.0)形成竞合格局,在网计算(INC)则越过了技术质疑期,正在成为Scale Up互联的关键技术特性。
在Scale-In层,核心特征是“光电一体、封装即互连”。CPO共封装光学把光引擎推进到封装内部:微环调制器量产、3D堆叠硅光引擎落地,光子引擎功耗降至约五分之一;光计算互联(OCI-MSA):目标能效~14pJ/bit,优先面向机架内短距(典型 5–10m),MSA 联盟已成立,规范最远支持 500m;混合键合I/O正向每平方毫米1万至100万个互连、低于0.05pJ/bit演进。
在Scale-Across这个新兴战场,需求已经明确但技术路线仍有分歧。百公里800G现网训练已实现98%以上的等效算力,超百T的GSE-DCI路由器试点落地;空芯光纤把时延降低31%(3.3μs/km以内)、损耗低至0.05dB/km,相干与轻相干方案正向1.6T演进。不过具体的技术路线上不同厂商和用户之间尚有分歧:长距稳定性是否必须依赖 Deep Buffer 交换架构,还是通过端侧算法优化适配,目前尚无定论。
沿着这条“片上→板级→集群→跨域”的竞争路线,产业价值重心的迁移越来越明显:Phase 1是GPU供应,Phase 2是HBM供应,Phase 3是先进封装产能,Phase 4是电力与散热,Phase 5是网络与光连接,Phase 6是物理数据中心容量。AI机架的物料清单早已不止GPU——CPU、HBM、网络、电源架、母排、BBU、CDU、歧管、固件、机架管理,真正的问题变成“每家供应商能控制多少机架级BOM”,一个趋势已然成型:第二代赢家,都不造GPU。高功率测试设备、高速连接器、热交换器、多芯光纤、BMC管理芯片,才是价值创造的下一层。
从开放生态的角度而言,行业应该重新思考Fungible(可互换性)的意义和实现路径,并将其作为开放互联标准的终极目标。

图5:开放互联生态进展,四个维度同步推进
6.谁在给这道题交答案?
技术讲完,最后收一句产业侧的注脚。在这场围绕互联展开的系统级竞争里,中兴通讯的选择很有代表性——它没有去卷GPU本身,而是把筹码压在“系统底座”上:
一是OEX正交超节点方案,以正交直连替代传统背板走线,把高速信号路径做短、做直,同时缓解高密度机柜内的信号完整性与串扰、改善散热风道、降低装配与维护复杂度,并与具体GPU芯片解耦,成为适配多样化国产算力的公共平台底座;
二是自研珠峰200 CPU,行业首款面向智算中心场景的RISC-V CPU,完整支持RVA23 Profile、RVV1.0与Vector Crypto,让整机得以在CPU、加速器、交换与互连之间做协同设计;
三是在OCP、ODCC、CLink计算总线等开放计算社区、标准组织长期参与,围绕服务器硬件形态、网络操作系统与互连接口贡献规范建议和代码——硬件可解耦、软件可替换、接口可互认。
结语
回到最初的问题:超级AIDC该如何Scale?
从三把剪刀差的现实压力,到多尺度Scale的分层突围,再到超节点与封装革命的技术台阶,最后到开放化从外层向内层倒逼的产业格局——一条完整的逻辑链是:竞争的尺度从芯片切换为系统,竞争的焦点从性能切换为Token成本,竞争的胜负手从单一产品切换为开放生态。
对开放互联标准化工作而言,第一问不是“哪种技术最强”,而是“界定需求、达成共识、给出指引”;对国内产业而言,这意味着谁参与定义接口,谁就参与定义下一代算力的成本结构。
(封面图来源:摄图网)
