
刚刚,Fable 5.2登顶RoboColiseum新榜单
新智元报道
新智元报道

在RoboColiseum新赛季公布的成绩中,Claude Fable 5.2 以18.30分拿下综合第一,精细操作、跨本体迁移分别得到33.04分和17.99分,两项同样领先。灵巧手,却成了这位综合冠军得分最低的一项。
精细操作拿下第一,为什么灵巧手却只得3.73分?用手挂衣服、把物体稳稳握在手里,这些人类习以为常的动作,对大模型究竟难在哪里?
RoboColiseum新赛季把机器人在现实世界真正要干的活搬进了考场,新增灵巧手操作、全身协同、精细操作与本体迁移四条赛道、50个任务。评测既看任务能否从头到尾完成,也会考察执行效率是否够快。

给手机充电、用衣架挂衣服、捡起垃圾、用钥匙开门——新赛道里的任务,都是机器人走进真实世界后要干的活。这些看似日常的工作,需要手指、双臂和身体协调配合完成。
RoboColiseum将这些实际需求搬进仿真考场,新增四条赛道、50个任务,检验模型能否把一件事从头到尾做完。
灵巧操作:从多指协同到使用工具。
挂起一件衣服,机器人要先抓住并撑开衣物,将衣架穿进去,再调整位置、挂到衣杆上。
衣服柔软、容易变形,多根手指需要配合抓握,双手也要协调动作,才能把这一连串操作做好。
该赛道共10项任务,还覆盖颠锅、还原魔方、系垃圾袋和双手搬运包裹等操作。
全身协同:底盘、躯干和双臂,要一起干活。
捡垃圾要先移动到合适的位置,再调整身体、伸手抓取;擦黑板时,要配合底盘移动和躯干调整,让手臂够到并擦净不同位置。
该赛道包含捡垃圾、放餐盘、传送带取货、钥匙开门、擦黑板等8项任务,考验的是机器人能否把移动和操作连续做下来。
精细操作:接头找到了,能不能插进去?
给手机充电,双臂需要分别控制手机与接头,把位置和方向同时对准。该赛道覆盖手机充电、拼积木、接网线、装轴承、手机打包等8类任务,考验小零件的对位、接触和装配。越接近完成,越需要把动作做准。
本体迁移:换一副「身体」,还能继续干活。
跨本体赛道包含挂杯子、换键帽、拿笔写字、倒水等6类任务,会放到ARX、AgileX、G1和G2四种机器人上分别测试,共构成24个评测任务。
机器人的关节结构、活动范围和夹持工具变了,模型也要相应调整动作。这里检验的是,同一个模型能否适应不同的机器人。
当前榜单汇总了8款Agent和3款策略模型的成绩。Claude Fable 5.2以18.30的综合分位列第一,GPT-6 Astra和Claude Opus 5.5分别以13.73和11.77分紧随其后。
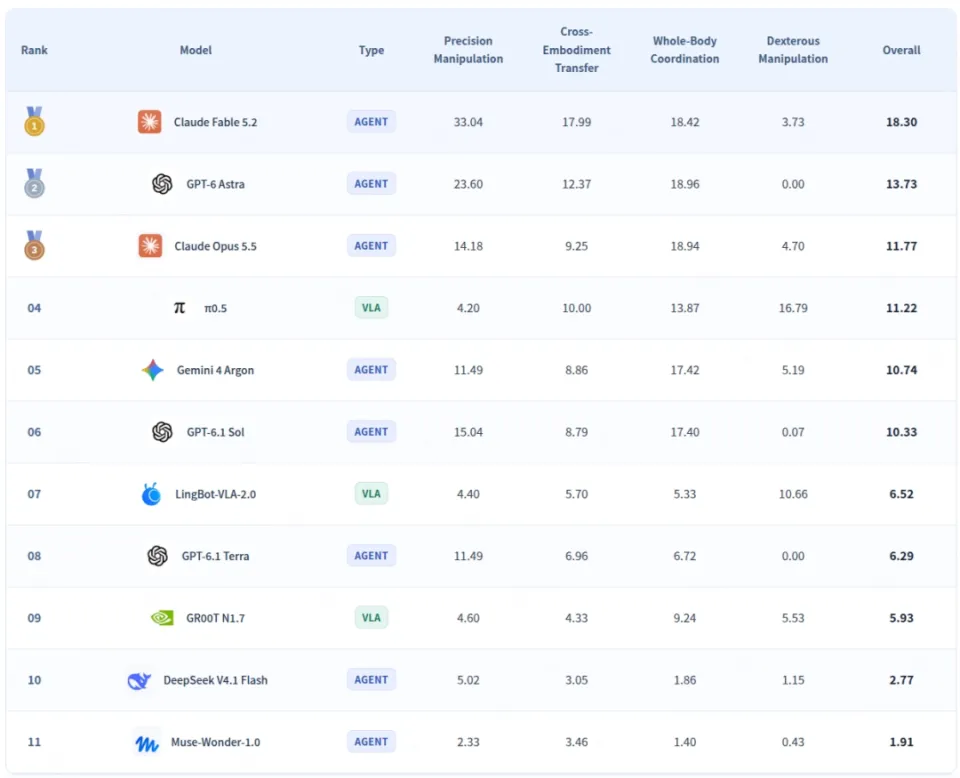
Fable拿下综合第一,也在精细操作和跨本体迁移上领先。这两项得分分别为33.04和17.99。全身协同中,Astra 得分18.96,Opus 为18.94,两者几乎持平。
但到了灵巧手赛道,8款Agent都遇到了自己的最低分。综合第一的Fable仅得3.73分,Astra与GPT-6.1 Terra均为0.00;Agent中该项得分最高的Gemini 4 Argon,也只有5.19分。多根手指如何配合、怎样稳稳抓住并操作物体,仍是这些大模型共同的难题。
策略模型则在灵巧手上拿出了更高的分数。π₀.₅以16.79分领跑该赛道,LingBot-VLA-2.0和GR00T N1.7分别得到10.66和5.53分,三者均高于本次榜单中的8款Agent。其中,π₀.₅还以11.22的综合分位列第四。
这张成绩单给擅长灵巧控制的团队留下了明确的挑战方向:在大模型尚未做好的操作上,策略模型已经展示了优势,也有机会继续拉开差距。
同一套题反复练,模型也可能靠「背题」拿高分。RoboColiseum新赛季加入三重防Hack机制,减少「背题」和使用特权信息带来的虚高分数,让成绩更能反映模型的真实水平。
第一重,隐藏测试集:练习场景公开,正式考题保留。
开发者可以使用开源场景进行开发和调试。服务器上的正式测试场景与其遵循相同分布,但具体布局不同,用来检验模型能否应对没练过的场景。
第二重,动态抽检:换一批题,再看表现。
平台保留固定的正式测试集用于计分,同时设置随每次提交变化的动态测试集。动态集不计入总分,而是与正式集作对照,检查模型是否过度适应固定考题。两组成绩差异过大,相关方案将受到上榜限制。
第三重,人工审核:排查违反评测规则的不当行为。
自动检查之外,平台加入人工审核,进一步识别违反评测规定,恶意获取分数的行为。
Agent与策略模型分开评,同类方案同榜比较。
Agent可以在观察、推理和动作之间反复切换,VLA、WAM等策略方案则通常以动作序列执行任务。两类方案的交互方式和执行节奏不同,本轮更新将它们区分管理,为Agent设置独立榜单,让参评团队能在同类方案中比较表现。
最后,执行效率也进入评分:完成任务,模型执行了多少次?
新规则为Agent设置执行次数限制,阈值参考训练数据。模型反复观察、思考和尝试,执行超过合理次数后,会按超出程度扣分。
任务完成情况同样重要:评分保留中间步骤的进展分,并对在规定步数内完成任务的方案给予额外奖励。任务做到哪一步、整项工作是否完成,以及用了多少步,都会影响最终成绩。
仿真评测价值几何,核心评判标准只有一个:仿真里跑出来的效果,能不能等价于真实世界表现。为了量化可信度,RoboColiseum开展大规模对照实验:不对仿真环境做任何适配调优,把真实世界训练出来的模型,直接扔进仿真环境做零样本评测(zero-shot real-to-sim)。
横跨4款不同机器人本体、覆盖22项复杂任务,最终测出仿真与真机任务得分相关性高达96.86%。
这意味着仿真中的评测分数不再是「虚拟成绩单」,仿真中发现的缺陷、验证有效的策略,可以高度可信地迁移到真实机器人,大幅降低真机调试试错成本。
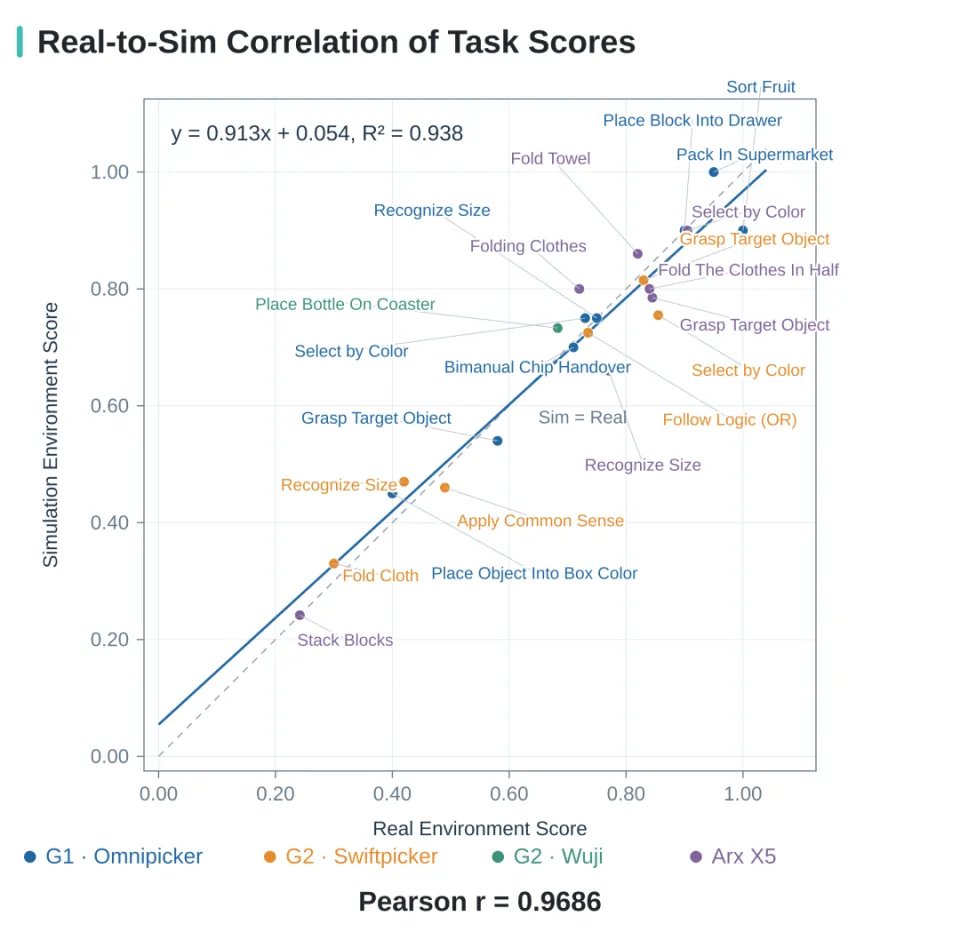
22项复杂任务真机-仿真评测结果一致性对比
准备数据、接入模型、提交评测、查看结果,一套流程通过与AI对话就能完成。
RoboColiseum提供AI可调用的Skills,完成安装与必要配置后,开发者即可与AI对话下载训练数据、接入推理服务并发起评测,更快跑通流程、拿到评测成绩。
在平台创建任务并启动推理后,RoboColiseum自动推进仿真运行、场景调度和评分,并提供任务进度、分项成绩与评测结果查询。从提交到查看成绩,各个环节都有支持,让团队把更多时间用在分析失败原因、改进模型上。
八大模型已经踏入RoboColiseum具身角斗场。本轮评测揭示,灵巧控制、精细操作与跨本体迁移仍有明显提升空间。这些尚未解决的难题,也为后来者留下了超越它们的机会。
四条新赛道、50个任务已经开放挑战。我们邀请策略模型和Agent系统的研发团队,带着自己的模型进入RoboColiseum向八大模型发起挑战。下一个超越它们的,可能就是你的模型。
新赛季的挑战已经开启,RoboColiseum的评测体系还将继续拓展。
进入RoboColiseum具身角斗场,参与评测,发起挑战!
编辑:元宇
