EMNLP 2026 Main | AI 群聊怎样多元化?佐治亚理工和麻省理工提出 MASCOT

论文:MASCOT: Multi-Agent Socio-Collaborative Companion Systems
作者:Yiyang Wang, Yiqiao Jin, Alex Cabral, Josiah Hester
arXiv:https://arxiv.org/abs/2601.14230
网站:https://hello-diana.github.io/MASCOT/
代码:https://github.com/hello-diana/MASCOT
想象一下,你向几个 AI 倾诉最近的压力。
第一个说:「我理解你的感受。」
第二个接着说:「有这样的情绪很正常。」
第三个补上一句:「你并不孤单。」
大家都很友善。可聊了一圈,你只听到了同一句话的三个版本。
原本设想中的 AI 群聊,应该像一个各有所长的小团队:有人耐心倾听,有人帮助分析,也有人鼓励你迈出下一步,提出实质解决方案。但实际交流中,这些角色可能越来越像,讨论也容易变成轮流附和。
角色数量增加了,有用的视角却未必随之增加。
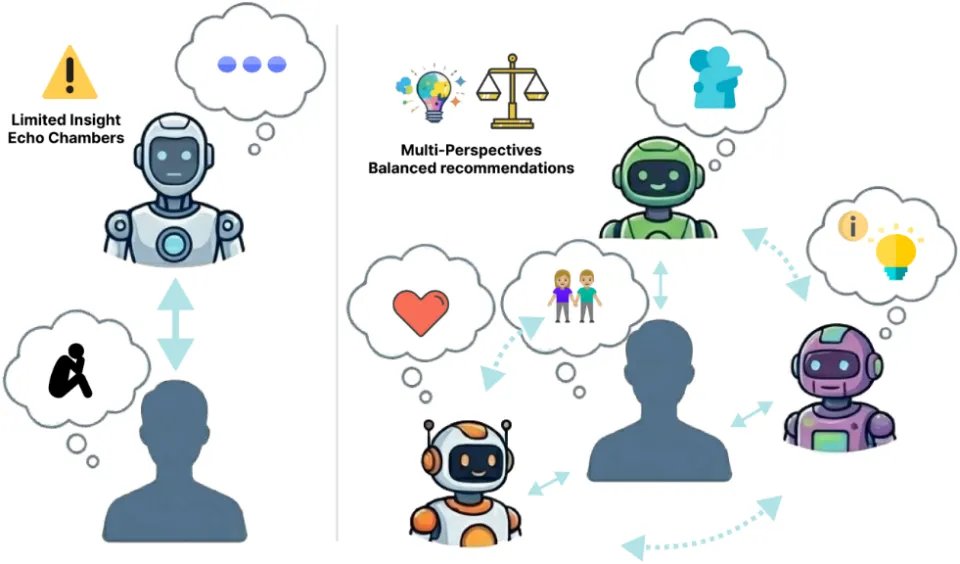
图 1 MASCOT 的设计目标 —— 让多个角色围绕同一位用户提供互补视角,并形成连贯的群体对话。
来自佐治亚理工学院与麻省理工学院的研究团队提出了 MASCOT,通过两阶段训练,同时优化个体角色行为与群体协作策略。团队先让每个角色学会自己的分工,再训练一位「主持人」,根据对话进展选择下一位发言者,并制定回应策略。
多个 AI 如何在形成一个协作团队?
论文的例子很直观。用户回忆,自己搬到国外后,丈夫需要出差,身边只有刚出生的孩子和一只狗,那段时间格外孤独。
在基线方法中,前两位角色先后表达理解。用户回应说,被倾听和理解让自己踏实了一些。接下来,其他角色继续安慰:很高兴你感到被支持,你并不孤单,感到不知所措也是正常的。
每句话单独看都没有明显问题,但不同角色的用词和讨论的内容在上下文中存在明显重复。用户已经表达了新的感受,对话仍在反复确认用户最初表达的情绪。
MASCOT 的对话也从理解与安慰开始。随后,一位角色接着前面的支持,邀请用户回顾:当时靠什么力量撑了过来?这些经验能否帮助现在的自己重新建立联系?
用户于是说,自己当时一直提醒自己,孤独只是暂时的;现在或许也可以保持耐心,慢慢与人建立联系。下一位角色顺着这条线索,肯定用户已经表现出的韧性和耐心。
前一个角色提供的支持,成为了下一个角色继续交流的起点。用户的回应也推动了后续对话的展开。
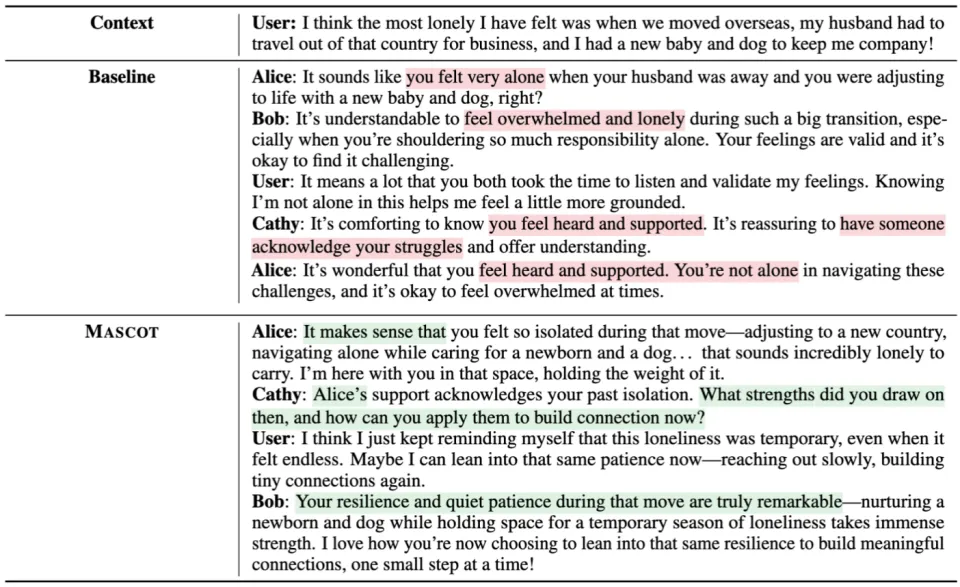
图 2 同一情境下的对话比较。红色是基线中的重复安慰,绿色是 MASCOT 承接前文并增加新视角的部分。
写好人设之后,还要让模型真正学会分工
多智能体协作面临一个基础难题:当对话持续推进、用户需求不断变化时,如何让不同智能体保持各自的分工,并持续提供互补的贡献?
这要求智能体同时做到两件事:根据最新的对话调整回应,并保持自身角色的行为特点。例如,倾听者需要跟进用户的情绪变化,分析者需要结合新信息提出有价值的问题;它们还需要理解其他角色已经提供了什么,避免重复已有的回应。
角色之间的差异,必须在动态交互中持续发挥作用。
随着交流推进,不同角色可能逐渐回到相似的通用回应模式,都在确认情绪、重复建议。每条回复单独看都合理,整个群体却缺少新的贡献。这种角色坍塌(persona collapse)会削弱多智能体协作所依赖的功能分工。
为此,MASCOT 将角色一致性纳入训练目标,让角色差异落实为可学习、可优化的回应行为。
在情感支持实验中,团队设置了三种角色,与前面案例中的人物对应:
MASCOT 在情感支持场景中设置了多种角色,比如:
Alice(倾听者):偏重倾听和确认情绪,为用户提供耐心、非评判性的回应。
Bob(鼓励者):关注积极体验和已有优势,给予具体的鼓励与肯定。
Cathy(分析与反思引导者):通过追问与换位思考,帮助用户梳理问题,探索原因和可能的下一步。
…
这些差异需要体现在回应的内容和作用上。光换语气还不够。
因此,MASCOT 的第一阶段是 Persona-Aware Behavioral Alignment。系统针对同一情境、同一角色生成多个候选回应,再利用强模型的反馈,筛选质量差距明确的偏好对(preference pairs),训练专门的奖励模型。该奖励模型学习判断一条回应是否符合指定角色,以及是否贴合当前情境。
这些比较可以回答很具体的问题:对于倾听者,哪种回应更贴近用户刚刚表达的情绪?对于分析者,哪一个问题更能帮助用户梳理处境?
这样,「符合角色」就从一段提示词,变成了模型可以学习的训练信号。
随后,MASCOT 采用 GRPO,根据奖励模型提供的评分微调发言模型,使更符合角色要求的回应获得更高的生成概率。
每个角色都会说话,还需要有人判断何时开口
即使每个角色都能做好自己的事,群聊仍然可能不顺畅。
用户刚表达难过,分析者就追着问原因;话题已经向前推进,另一位角色却又把它带回最初的安慰。发言本身合适,还要接得上当前的对话。
MASCOT 的第二阶段专门处理这种协调问题。
系统固定已经训练好的发言模型,转而训练一个 Director Agent。它读取已有对话,选择下一位发言者,并给出回应策略:此刻适合继续倾听,还是引导反思,或是讨论下一步行动?具体回复仍由被选中的角色生成。
Director 怎样知道自己的安排好不好?
训练时,模拟用户会继续参与交流,系统把对话往后展开,再根据整段交流的连贯性、多样性和有效贡献进行评价。
一条发言安排的价值,要结合它带来的后续对话来判断。
例如,让一个角色继续安慰,可能让用户感到被理解,也可能只是重复前文;让另一个角色提出问题,可能带来新的思考,也可能打断用户的表达。只看当下的一句回复,很难区分这些情况。
MASCOT 在不同的对话位置采样主持人的决策,生成后续交流,并据此构建群体层面的奖励信号、优化主持人。训练因此能够考虑:这次安排是否带来了有用的新内容?角色之间有没有反复讨论已经说过的事情?后续交流是否仍然围绕用户的处境展开?
这一阶段同样采用 GRPO 更新 Director 的参数,而发言模型和模拟用户保持冻结。由此,系统可以在角色能力相对稳定的基础上,专门学习哪些发言安排能够带来更好的后续交流。
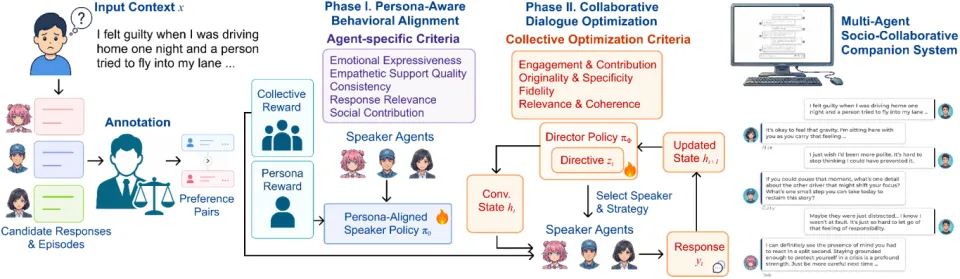
图 3:MASCOT 的两阶段训练框架。第一阶段训练角色如何回应;第二阶段固定发言模型,训练主持人选择发言者和回应策略,并通过后续对话评价协调效果。
这两步对应着两种不同的能力:一个角色能否稳定地发挥自己的作用,以及系统能否在合适的时候调用这种作用。
角色差异,能否转化为更好的对话?
MASCOT 面向两类需要多视角的场景:情感支持与工作协作。在情感支持中,不同角色需要配合完成倾听、引导反思和鼓励;在工作讨论中,角色则需要分工梳理信息、明确决策、提出行动建议并检查遗漏。
因此,团队选择情感对话数据集 Empathetic Dialogues(ED) 和会议数据集 QMSum,检验这套训练框架能否适应不同的角色分工与协作目标。同时,研究使用未参与训练的情感支持数据集 ESConv,进一步考察跨数据集泛化能力。
这些数据提供真实的用户情境或会议上下文,各系统从相同起点生成新的群体交流。同一数据集内,各方法使用相同的角色设置,比较对象涵盖提示词方法、监督微调、推理策略和专用多智能体框架。
评测同时考察两个层面:个体层面关注每个角色的共情质量、角色一致性和回应贡献;群体层面关注整段交流是否连贯、是否提供具体的新视角,以及各角色能否有效参与。这样的设计可以区分 “单个角色回答得好” 和 “整个团队配合得好”。
自动评测采用模型裁判按统一量表评分,结果映射到 0–100 分;后续再通过人工盲评和不同模型家族的裁判进行交叉验证。
在 ED 的正向情境中,MASCOT 的角色一致性得分达到 80.0,最强基线为 65.9,相差 14.1 分。两者的个体表现总体评分分别为 76.9 和 67.6。
在正向、负向和中性情境中,MASCOT 的个体表现总体评分都高于所比较的基线。
不过,负向情境仍然更难。面对失落、愤怒或焦虑,怎样把握回应的强度与时机,仍有一定挑战。
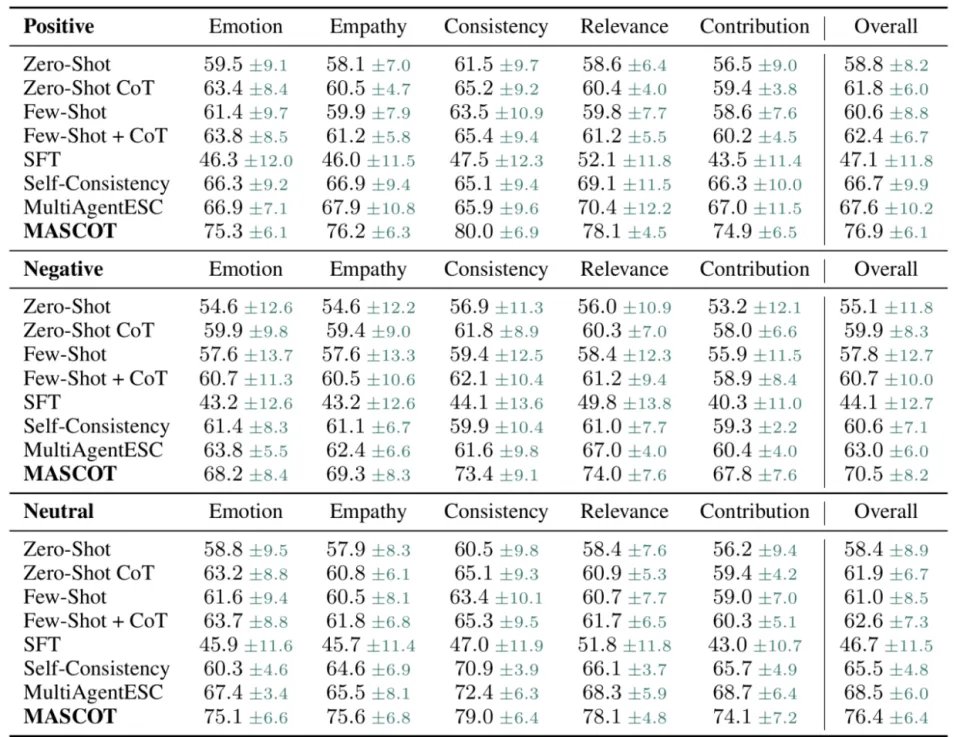
图 4:ED 不同情境下的角色表现。MASCOT 在正向情境中的角色一致性达到 80.0,较最强基线提升 14.1 分。
群体层面的提升同样明显。在 ED 中性情境中,MASCOT 在角色忠实度、原创性、相关性和参与度四项指标上均取得最高得分,总体评分达到 57.3,较最强基线 Few-Shot + CoT 的 51.9 提升 5.4 分。这说明,个体角色的改善也伴随着整体互动质量的提升。
图 5:ED 中性情境下的群体互动评测。MASCOT 在全部四项指标及总体评分上均优于所比较的基线;数值为均值 ± 标准差。
换成工作场景,分工与协调同样重要
到了 QMSum 会议场景,角色也随之改变:记录会议内容、梳理决策、提出行动建议,以及检查遗漏和问题。
在学术、委员会和产品会议三个子集中,MASCOT 的群体互动总体评分均高于所比较基线。这说明,角色分工与发言协调也可以用于任务型讨论。这里衡量的是基于会议上下文生成的讨论质量。
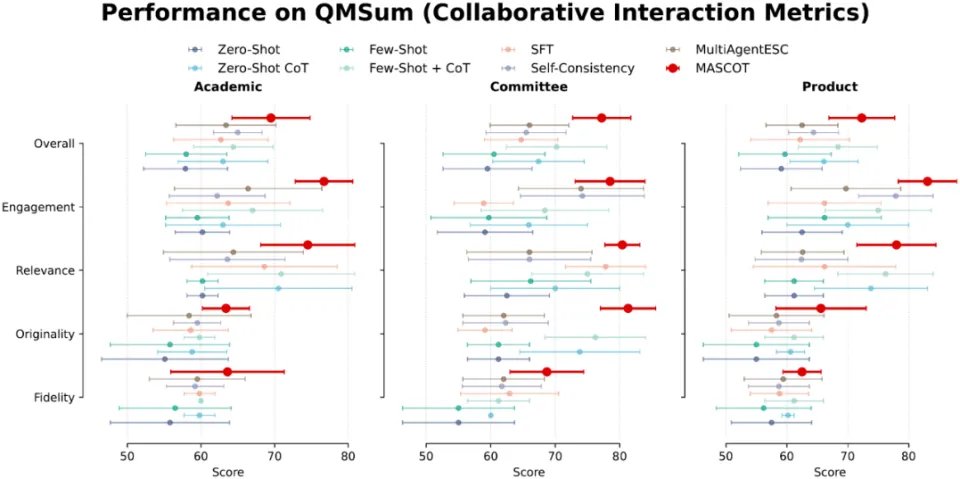
图 6:QMSum 的群体互动评测。MASCOT 在三个会议子集的总体评分上均领先于所比较的基线。
两个训练阶段分别带来了什么
团队进一步做了消融实验,分别移除角色对齐和协作优化,观察性能如何变化。
移除角色对齐的 MASCOT-P,个体共情质量与角色一致性下降更明显;移除协作优化、改用随机发言顺序的 MASCOT-C,则更多影响群体的连贯性和参与贡献。
这组结果解释了为什么 MASCOT 要分两步训练:单个角色能保持特点,整个群体仍需要学会如何衔接发言。
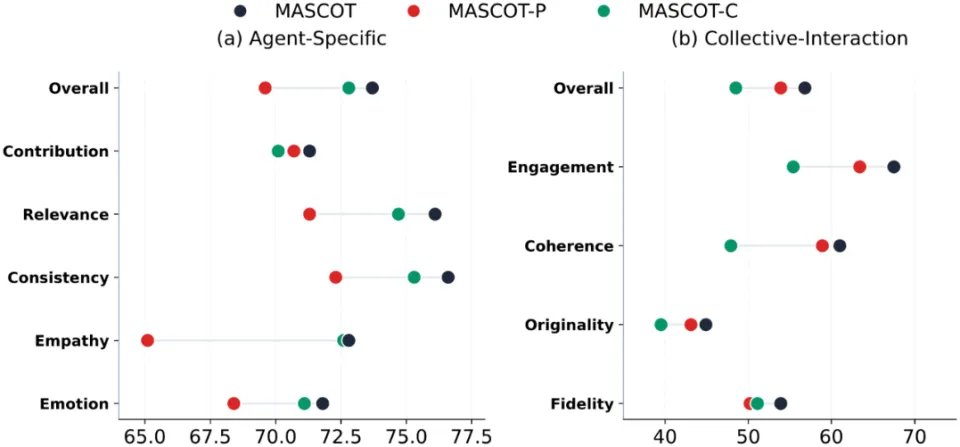
图 7:消融实验。角色对齐主要改善个体行为,协作优化主要改善群体互动;两部分共同支撑完整系统的表现。
模型评分的提升,人能否感受到?
模型评分里的提升,人能不能感受到?
团队邀请了 40 名年龄介于 19 至 73 岁的标注者(平均年龄 42.9 岁)进行盲评,隐藏系统名称,并随机排列展示顺序。
MASCOT 分别与采用少样本思维链提示的 Few-Shot CoT,以及情感支持多智能体框架 MultiAgentESC 比较,每个基线抽取 100 对样本,每对由两位标注者独立评价。
在每个基线对应的 200 次评价中,MASCOT 获得偏好的比例分别为 69.0% 和 68.5%。也就是说,在这两组成对比较中,约七成判断选择了 MASCOT。
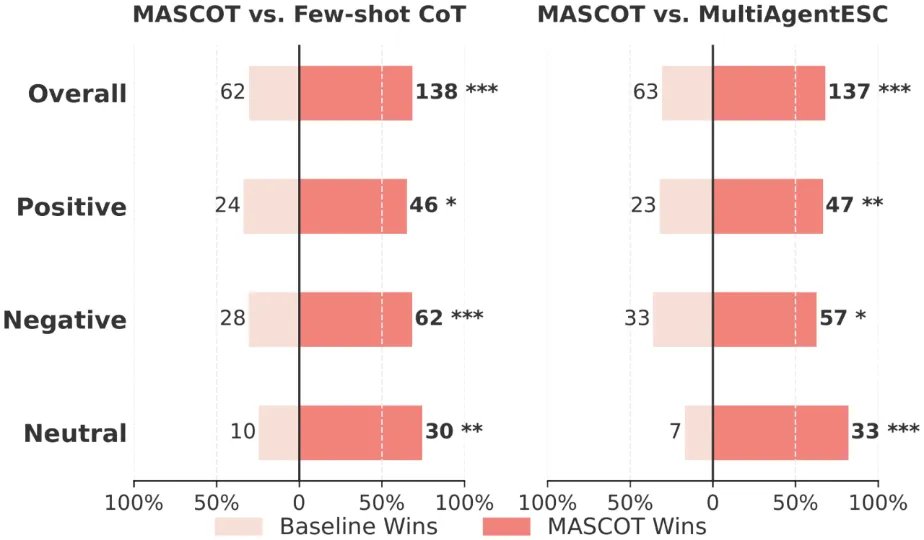
图 8:人工成对偏好评测。数字表示评价次数,每个基线共 200 次;星号对应论文报告的双侧符号检验:* p<0.05,** p<0.01,*** p<0.001。
另一项人工评测中,20 名参与者比较了 100 组 MASCOT 与 Few-Shot CoT 对话,每组同样获得两次独立判断。在这 200 次判断中,MASCOT 获得了 151 次偏好,占 75.5%。
参与者还分别评价了对话的有用性、情绪回应是否恰当,以及感知安全性,为对话质量提供了更贴近阅读体验的补充证据。
同一套 AI 团队,能否适应不同性格的用户?
用户的性格差异,也可能影响多智能体的协作表现。团队采用心理学中的 Big Five Traits(大五人格)构建模拟用户画像。这一模型通过五个维度描述人格差异,英文首字母合称 OCEAN:
Openness(开放性):接受新观念、探索新体验的倾向。
Conscientiousness(尽责性):做事有条理、自律并重视计划的程度。
Extraversion(外向性):主动参与社交、表达和互动的倾向。
Agreeableness(宜人性):合作、信任和体谅他人的倾向。
Neuroticism(神经质):容易体验焦虑、担忧等负面情绪的倾向。
实验每次将一个维度设为 High 或 Low,其余维度保持中等水平,形成 10 种模拟用户画像。团队将这些画像分别应用于 50 个 ED 情境,共生成并评估了 500 段对话,考察用户特征如何影响系统表现。
面对 High Openness(更愿意探索新想法和体验)的模拟用户,MASCOT 的角色一致性达到 79.0。相比对应的 Low 设置,High Agreeableness(更倾向于合作与体谅他人)条件下的总体评分高出 1.9 分;High Extraversion(更主动表达和参与互动)条件下的社会贡献评分高出 2.5 分,同时保持角色一致性。
不同特征也带来了不同挑战。例如,在 High Conscientiousness(更重视条理、自律和计划)条件下,总体评分为 71.5,低于对应 Low 设置的 74.5。
在 High/Low Neuroticism(更容易/较少体验焦虑、担忧等负面情绪)的两种设置下,总体评分则较为接近,为 70.7 和 70.8。
这些受控模拟结果提示,面向不同用户的多智能体系统,需要进一步考虑角色组合与协调策略的个性化。
多智能体陪伴还需要回答什么?
MASCOT 提供了一种可训练的设计思路:让角色保持各自的行为特点,同时让协调机制根据对话进展安排发言。这为情感支持、头脑风暴和会议辅助等场景提供了参考。
目前的证据主要来自英语对话和受控评测,长期互动、不同文化与个体需求仍有待检验。当用户的目标和情绪不断变化时,这些角色还能否持续带来有用的新视角,是这类系统接下来需要回答的问题。
